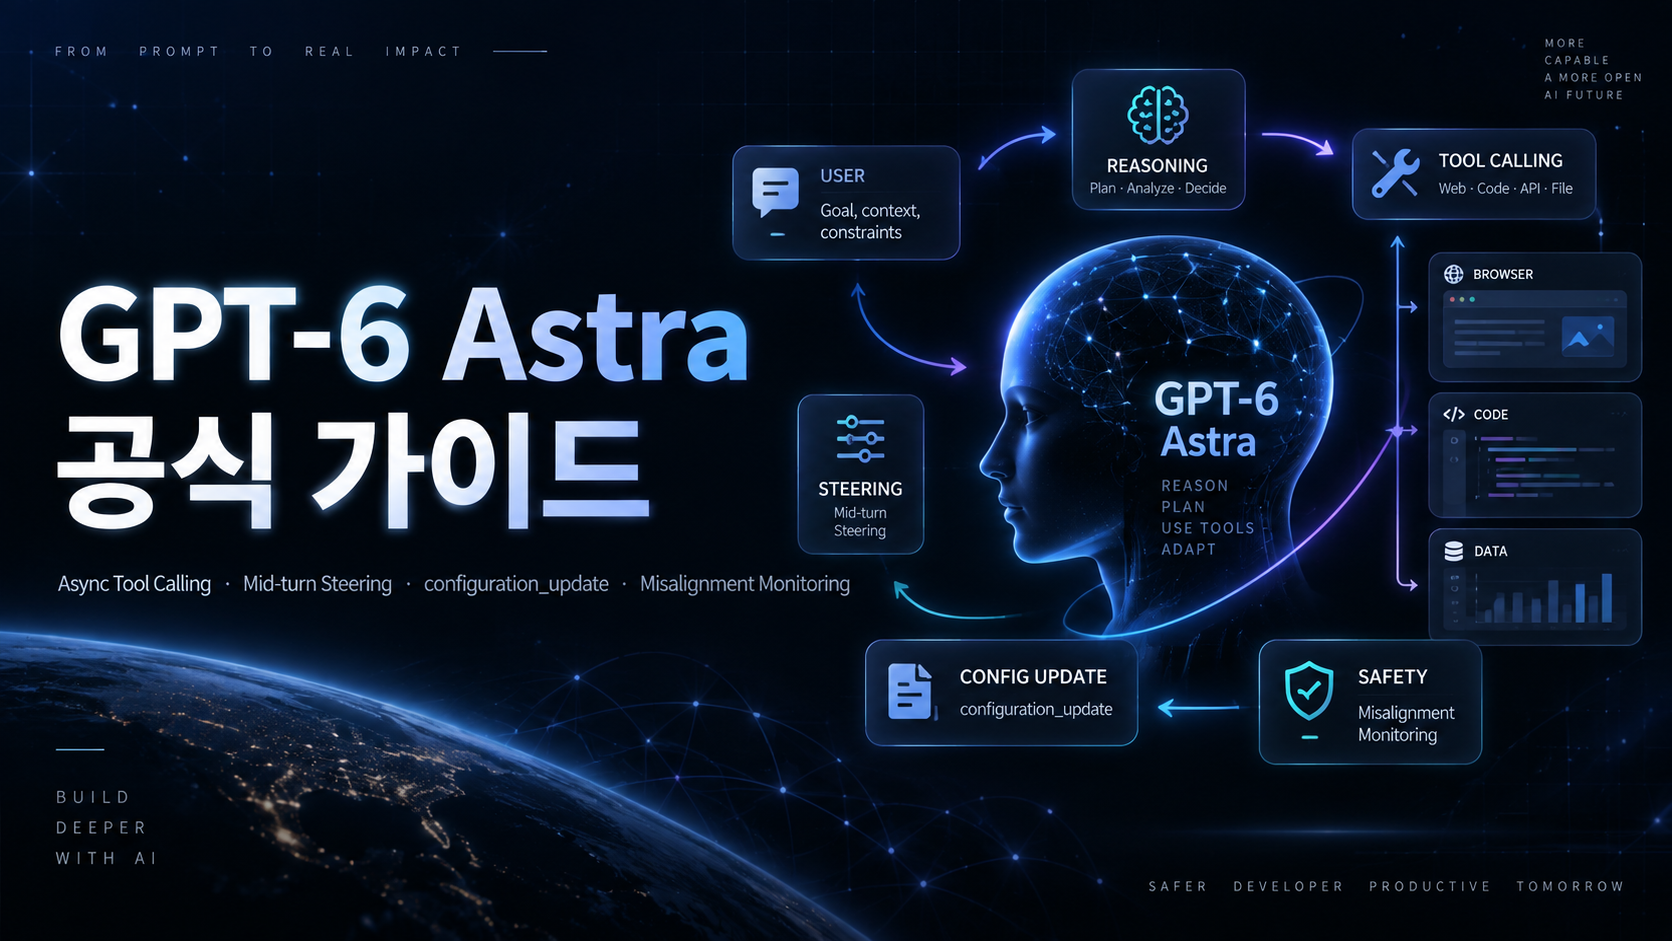
OpenAI가 2026년 9월 3일 GPT-6 Astra를 공식 공개했습니다.
GPT-6 Astra는 단순히 GPT-5 계열보다 성능이 향상된 새로운 언어 모델이 아닙니다. OpenAI가 공개한 공식 API 문서를 살펴보면 이번 변화의 핵심은 AI가 답변을 잘 만드는 것에서, 실제 작업을 장시간 수행하는 에이전트로 진화하는 것에 더 가깝습니다.
OpenAI는 GPT-6 Astra를 자사의 가장 강력한 모델로 소개하며 복잡한 추론, 소프트웨어 개발, 웹 브라우징, 컴퓨터 사용, 연구, 문서 작성과 같은 여러 단계의 작업을 처음부터 끝까지 수행하도록 설계했다고 설명합니다.
특히 개발자 입장에서 주목할 변화는 네 가지입니다.
Async Tool Calling
Mid-turn Steering
configuration_update
Misalignment Monitoring
그리고 이 기능들은 OpenAI가 오랫동안 추진해 온 Responses API 중심의 에이전트 아키텍처와 밀접하게 연결되어 있습니다.
1. GPT-6 Astra는 무엇이 달라졌을까?
OpenAI 공식 모델 가이드에서는 GPT-6 Astra를 다음과 같은 영역에 강한 모델로 설명합니다.
- Computer Use
- Browsing
- Software Engineering
- Science
- Professional Work
- 복잡한 Multi-step Workflow
특히 코드 작성 → 브라우저 조사 → 도구 실행 → 결과 분석 → 문서 작성처럼 서로 다른 작업 환경을 넘나드는 워크플로우에 초점을 맞췄습니다.
모델 사양도 상당히 커졌습니다.
항목GPT-6 Astra
| 모델 ID | gpt-6-astra |
| Context Window | 1,050,000 tokens |
| 최대 출력 | 128,000 tokens |
| Reasoning Effort | low / medium / high / xhigh / max |
| 입력 가격 | $10 / 1M tokens |
| Cached Input | $1 / 1M tokens |
| Cache Write | $12.50 / 1M tokens |
| 출력 가격 | $50 / 1M tokens |
공식 모델 문서 기준으로 GPT-6 Astra는 약 105만 토큰의 컨텍스트 윈도우와 최대 12만8천 토큰 출력을 지원합니다.
단순히 컨텍스트를 크게 만든 것이 중요한 것은 아닙니다.
OpenAI가 Astra에서 추가한 기능들을 보면 앞으로의 AI 애플리케이션이 어떤 방향으로 가고 있는지 더 분명하게 알 수 있습니다.
2. 가장 중요한 변화: Async Tool Calling
기존 AI 에이전트의 Tool Calling은 기본적으로 동기식 구조였습니다.
예를 들어 모델이 다음 작업을 해야 한다고 가정해 보겠습니다.
- 서울 날씨 조회
- 비행기 가격 조회
- 호텔 가격 조회
- 여행 일정 생성
기존 방식에서는 도구를 호출하면 결과를 기다린 뒤 다음 추론을 계속하는 경우가 많았습니다.
개념적으로는 다음과 같습니다.
AI 추론
   ↓
도구 호출
   ↓
결과 기다림
   ↓
AI 추론 재개
외부 API 응답에 10초가 걸리면 그동안 모델의 진행도 사실상 멈춥니다.
GPT-6 Astra에서는 이를 개선하기 위해 Async Tool Calling이 도입됐습니다.
함수 또는 Custom Tool에 다음과 같이 비동기 실행 가능 여부를 지정할 수 있습니다.
{
  "type": "function",
  "name": "search_flight",
  "async": true
}
이제 Astra는 도구 결과를 기다리는 동안 결과와 무관한 다른 작업을 계속 진행할 수 있습니다.
구조가 다음처럼 달라질 수 있습니다.
             ┌─ 항공권 검색 ─────┐
AI 추론 ────┼─ 호텔 검색 ───────┼── 결과 종합
             └─ 여행 일정 초안 ──┘
중요한 점이 하나 있습니다.
async: true를 붙였다고 OpenAI 서버가 개발자의 함수를 대신 실행하는 것은 아닙니다.
도구 실행과 작업 상태 관리는 여전히 애플리케이션에서 담당해야 합니다.
도구 작업이 완료되면 기존 Tool Calling처럼 원래 call_id에 해당하는 결과를 다시 모델에 전달합니다.
즉 Async Tool Calling의 목적은
외부 작업의 실행을 OpenAI에 위임하는 것이 아니라 모델이 기다리느라 낭비하는 시간을 줄이는 것
이라고 이해하면 좋습니다.
3. Wait Tool Pattern: 필요한 순간에만 기다린다
OpenAI 문서는 Async Tool Calling에서 한 단계 발전한 패턴도 설명합니다.
바로 Wait Tool Pattern입니다.
예를 들어 AI가 두 사이트에서 상품 가격을 조회한다고 생각해 보겠습니다.
쇼핑몰 A 가격 검색 ───────┐
                          ├── 가격 비교
쇼핑몰 B 가격 검색 ───────┘
가격 검색이 진행되는 동안 모델은
- 제품 특징 정리
- 비교 기준 결정
- 보고서 구조 생성
같은 작업을 먼저 할 수 있습니다.
그리고 실제 가격을 비교해야 하는 순간에만 개발자가 만든 wait_for_tasks 같은 함수를 사용해 결과를 기다리는 방식입니다.
이 패턴은 AI Agent 시스템에서 상당히 중요합니다.
기존 방식이
도구 호출 → 대기 → 작업
이었다면 앞으로는
도구 호출
     ↓
독립 작업 계속 수행
     ↓
결과가 필요한 순간에만 대기
하는 구조가 가능해지기 때문입니다.
복잡한 리서치 에이전트나 데이터 분석 에이전트에서는 전체 처리시간을 상당히 줄일 수 있는 구조입니다.
4. Mid-turn Steering: AI가 작업 중이어도 지시를 바꿀 수 있다
두 번째로 흥미로운 기능은 Mid-turn Steering입니다.
기존 LLM 애플리케이션에서는 모델이 긴 작업을 시작하면 일반적으로 응답이 끝날 때까지 기다려야 했습니다.
예를 들어 AI에게
SaaS 서비스를 기획하고 MVP 개발 계획을 만들어줘.
라고 요청했다고 가정해 보겠습니다.
작업 도중 사용자가
개발자 한 명이 2주 안에 만들 수 있는 수준으로 줄여줘.
라고 조건을 추가하고 싶을 수 있습니다.
GPT-6 Astra에서는 작업이 완료되기 전에 이런 추가 지시를 보낼 수 있습니다.
개념적인 이벤트는 다음과 같습니다.
{
  "type": "response.steer",
  "previous_response_id": "resp_123",
  "input": "MVP 범위를 개발자 한 명이 2주 안에 완성할 수 있도록 줄여라."
}
Mid-turn Steering은 Responses API를 WebSocket 방식으로 사용할 때 제공됩니다.
구조적으로 보면
사용자 요청
   ↓
AI 작업 시작
   ↓
분석
   ↓
사용자 추가 요구사항
   ↓
방향 수정
   ↓
작업 계속
이 가능해진 것입니다.
이 기능은 긴 작업을 수행하는 AI Agent에서 특히 중요합니다.
예를 들어 Codex 같은 코딩 에이전트가 프로젝트를 수정하고 있을 때 사용자가 중간에
데이터베이스는 PostgreSQL 대신 SQLite로 바꿔.
라고 지시할 수도 있습니다.
AI가 처음부터 모든 작업을 다시 시작하는 대신 이미 끝난 작업을 최대한 보존하면서 새로운 조건을 이후 작업에 반영할 수 있습니다.
5. configuration_update: 대화 도중 추론 강도를 변경한다
GPT 계열 Reasoning 모델에는 reasoning.effort라는 개념이 있습니다.
쉽게 말하면 모델에게
이 문제를 얼마나 깊게 생각할 것인가?
를 지정하는 설정입니다.
GPT-6 Astra가 지원하는 공식 추론 강도는 다음과 같습니다.
low
medium
high
xhigh
max
하지만 실제 AI Agent에서는 모든 문제가 같은 난이도가 아닙니다.
예를 들어 하나의 세션에서도
사용자 이름 변경 → 쉬움

DB Migration 설계 → 어려움

버튼 문구 변경 → 쉬움

Production 장애 분석 → 매우 어려움
이런 작업이 번갈아 나타날 수 있습니다.
이때 매 요청마다 reasoning.effort를 바꾸면 Prompt Cache 효율에 영향을 줄 수 있습니다.
이를 해결하기 위해 Astra에는 configuration_update 입력 항목이 추가됐습니다.
개념적으로는 다음과 같이 사용할 수 있습니다.
input = [
    {
        "type": "configuration_update",
        "reasoning": {
            "effort": "high"
        }
    },
    {
        "role": "user",
        "content": "장애 원인을 분석하고 rollback 전략을 설계해줘."
    }
]
따라서 하나의 장기 세션에서도
일반 작업       → low
복잡한 분석     → high
일반 후속 작업  → low
난해한 문제     → xhigh
처럼 추론 자원을 조절할 수 있습니다.
AI Agent의 비용과 지연 시간을 관리하는 데 매우 중요한 기능입니다.
6. Astra에서는 reasoning effort none을 사용할 수 없다
기존 일부 GPT 모델에서는 추론을 거의 사용하지 않는 none 설정을 사용할 수 있었습니다.
하지만 GPT-6 Astra 공식 가이드에서는 none을 지원하지 않는다고 명시하고 있습니다.
따라서 기존 애플리케이션에서
none
minimal
등을 사용하고 있었다면 OpenAI는 Astra 마이그레이션 시 low부터 테스트할 것을 권장합니다.
즉 기존 코드에서 단순히
model="gpt-5.6"
을
model="gpt-6-astra"
로 바꾸는 것만으로 마이그레이션이 끝나지 않을 수 있습니다.
7. Misalignment Monitoring: 에이전트 행동까지 감시한다
GPT-6 Astra에서 기술적으로 가장 흥미롭고 동시에 중요한 변화 중 하나는 Misalignment Monitoring입니다.
Astra는 단순한 챗봇이 아니라
- 브라우저 조작
- 코드 실행
- 파일 수정
- 외부 시스템 접근
같은 작업을 수행할 수 있습니다.
모델의 능력이 강해질수록
사용자가 실제로 허용한 범위를 벗어나 행동하지 않는가?
라는 문제가 중요해집니다.
OpenAI는 이를 위해 Astra에 비정렬 행동을 감시하는 추가 안전 모니터링을 적용했습니다. 공식 가이드는 이 시스템이 비동기적으로 모델의 행동을 검토하고 필요한 경우 경고를 생성할 수 있다고 설명합니다.
특히 OpenAI는 Astra를 자사 Preparedness Framework 기준으로 Critical 수준의 사이버보안 역량에 도달한 최초의 모델로 분류했습니다.
따라서 Astra 같은 에이전트 모델에서는 단순한 콘텐츠 필터링보다
사용자의 의도
      ↓
에이전트가 이해한 작업
      ↓
실제 수행하려는 행동
사이의 정렬 여부가 훨씬 중요해집니다.
OpenAI는 동시에 이런 모니터링이 완벽하지 않다고 설명합니다.
정상적인 작업이 잘못 감지될 가능성도 있기 때문에 중요한 외부 작업에서는 여전히
- 사용자 승인
- 권한 제한
- 감사 로그
- 애플리케이션 자체 안전장치
를 유지하는 것이 필요합니다.
8. GPT-6 Astra부터 Responses API의 중요성이 더 커졌다
GPT-6 Astra는 Chat Completions API 자체를 완전히 제거하지 않았습니다.
공식 릴리스 노트에는 다음 두 엔드포인트가 모두 표시되어 있습니다.
/v1/responses
/v1/chat/completions
하지만 중요한 차이가 있습니다.
Astra에서 Tool Calling을 사용하려면 Responses API가 필요합니다.
OpenAI의 공식 마이그레이션 가이드도 명확하게
Tool calling: Use the Responses API.
라고 안내합니다.
즉 앞으로 AI 에이전트를 개발한다면 사실상 다음 구조를 기본으로 보는 것이 좋습니다.
Application
     │
Responses API
     │
GPT-6 Astra
     │
 ┌───┼──────────────┐
 │   │              │
Tools Browser   Computer Use
 │
External API
Chat Completions는 전통적인 채팅 인터페이스를 위해 남아 있지만 복잡한 Agent Workflow는 Responses API 중심으로 이동하고 있다고 볼 수 있습니다.
9. 마이그레이션할 때 반드시 확인할 파라미터
OpenAI 공식 Model Guidance에서 제시하는 GPT-6 Astra 마이그레이션 항목을 실무 관점에서 정리하면 다음과 같습니다.
기존 설정GPT-6 Astra
| none / minimal reasoning | low부터 테스트 |
| Tool Calling | Responses API 사용 |
| temperature | 제거 |
| top_p | 제거 |
| top_logprobs | 제거 |
| reasoning을 요청마다 변경 | configuration_update 검토 |
| prompt_cache_retention | prompt_cache_options.ttl 사용 |
| EU Fast Mode | 지원 제한 확인 |
특히 다음 파라미터를 그대로 전달하면 안 됩니다.
temperature
top_p
top_logprobs
Chat Completions에서는 logprobs도 제거해야 하며 Responses API에서는 include에 있던 관련 logprob 설정도 확인해야 합니다.
10. Prompt Cache의 비용 구조도 확인해야 한다
GPT-6 Astra의 기본 API 가격은 다음과 같습니다.
Input       $10 / 1M tokens
Cached      $1 / 1M tokens
Cache Write $12.50 / 1M tokens
Output      $50 / 1M tokens
여기서 주목할 것은 캐시 읽기는 매우 저렴하지만 캐시 생성에는 비용이 든다는 점입니다.
예를 들어 수만 토큰에 달하는 시스템 프롬프트나 개발 문서를 매 요청마다 그대로 보내는 AI Agent라면 Prompt Cache의 활용 여부에 따라 전체 운영 비용이 크게 달라질 수 있습니다.
따라서 프로덕션에서는 단순히 API 토큰 사용량뿐 아니라
input tokens
cached tokens
cache write tokens
output tokens
을 별도로 측정하는 것이 좋습니다.
또 Astra 모델 문서에는 272K 입력 토큰을 초과하는 요청의 경우 별도 장문 컨텍스트 요율이 적용된다고 명시되어 있으므로, 100만 토큰 컨텍스트를 사용할 수 있다는 이유만으로 무조건 컨텍스트를 크게 만드는 것은 비용 측면에서 좋은 전략이 아닙니다.
11. 프롬프트 엔지니어링도 달라진다
GPT-6 Astra의 공식 가이드에서 의외로 중요한 부분은 모델 성능 자체보다 모델의 행동을 어떻게 조정할 것인가입니다.
OpenAI가 설명하는 Astra의 특징을 정리하면 크게 다음과 같습니다.
주도성과 작업 완수
Astra는 작업 경계를 신중하게 판단하기 때문에 결과에 영향을 줄 수 있는 정보가 부족하면 질문할 수 있습니다.
하지만 완전 자율 에이전트에서는 질문이 너무 많아지는 것이 오히려 단점이 될 수 있습니다.
이런 시스템에서는 프롬프트를 다음과 같은 방향으로 설계할 수 있습니다.
현재 대화와 지시에서 합리적으로 추론할 수 있는 정보는 스스로 판단한다.

결과를 실질적으로 바꿀 정보가 없는 한 작업을 중단하지 않는다.

되돌릴 수 있는 작업과 읽기 전용 작업은 계속 수행한다.

승인이 필요한 작업은 검토 가능한 결과를 먼저 완성한 후 마지막 단계에서 요청한다.
첨부 자료 역시 Astra의 중요한 행동 특성으로 Initiative and follow-through를 강조하고 있습니다.
12. 강력해진 Instruction Following에는 부작용도 있다
모델이 지시를 잘 따르는 것은 당연히 좋은 일처럼 보입니다.
하지만 복잡한 AI 개발 환경에서는 문제가 생길 수 있습니다.
예를 들어 프로젝트에
SYSTEM PROMPT
AGENTS.md
SKILL.md
Tool description
Repository instruction
User prompt
등 수십 개의 지시가 존재할 수 있습니다.
이 중 오래된 SKILL.md 하나에
변경 전에 반드시 사용자에게 다시 확인한다.
라는 규칙이 남아 있다면 강력한 Instruction Following 능력을 가진 모델은 그 지시를 충실하게 따를 가능성이 높습니다.
그 결과 사용자는
왜 자꾸 물어보지?
라고 느끼게 됩니다.
따라서 Astra 같은 모델로 마이그레이션할 때는 프롬프트를 계속 추가하는 것보다 먼저 Prompt Harness Audit을 수행하는 것이 중요합니다.
확인할 대상은 다음과 같습니다.
System Prompt
Developer Instructions
AGENTS.md
SKILL.md
Tool descriptions
MCP descriptions
Repository rules
Legacy prompts
강한 모델일수록 프롬프트가 필요 없어진다는 의미보다는 잘못된 프롬프트의 영향도 더 커진다고 보는 것이 정확합니다.
13. 테스트 전략도 바꿀 필요가 있다
Astra는 코드 변경 후 검증을 상당히 적극적으로 수행하도록 설계되어 있습니다.
큰 프로젝트에서는 장점입니다.
하지만 작은 수정까지 매번
전체 테스트
통합 테스트
회귀 테스트
빌드
Lint
Type Check
를 모두 수행하면 Agent 작업 시간이 불필요하게 길어질 수 있습니다.
따라서 Coding Agent에서는 검증 수준을 변경 위험에 맞춰 명시하는 것이 좋습니다.
예를 들어
작은 UI 변경
→ 관련 테스트 + lint

비즈니스 로직 변경
→ unit + integration

DB Schema 변경
→ migration + integration + rollback 검증

Production 핵심 로직
→ 전체 regression
처럼 작업 위험에 따라 검증 범위를 조절하면 됩니다.
14. GPT-6 Astra가 보여주는 AI Agent의 방향
GPT-6 Astra의 공식 문서를 읽고 나면 한 가지 방향이 분명해집니다.
LLM 개발의 중심이
Prompt → Answer
에서
Goal
 ↓
Reasoning
 ↓
Tool
 ↓
Observation
 ↓
Action
 ↓
Verification
 ↓
Result
구조로 빠르게 이동하고 있다는 것입니다.
Async Tool Calling은 대기 시간을 줄이고,
Mid-turn Steering은 실행 도중 사용자가 개입할 수 있게 하고,
configuration_update는 작업 난이도에 따라 추론 자원을 조정하며,
Misalignment Monitoring은 강력해진 Agent의 행동 범위를 감시합니다.
이 네 가지가 서로 독립적인 기능처럼 보이지만 실제로는 하나의 방향을 가리키고 있습니다.
바로 Long-running AI Agent입니다.
15. 개발자가 지금 확인해야 할 체크리스트
현재 GPT-5.x 기반 시스템을 운영한다면 Astra 도입 전에 다음 순서로 확인하는 것이 좋습니다.
① Responses API 사용 여부
Agent나 Tool Calling을 사용한다면 Responses API 구조를 우선 검토합니다.
② 기존 Prompt Harness 감사
AGENTS.md, SKILL.md, System Prompt 등 오래된 지시가 충돌하지 않는지 확인합니다.
③ Reasoning Effort 재측정
기존 none 또는 minimal을 사용했다면 low부터 실제 평가 데이터를 다시 수집합니다.
④ Prompt Cache 분석
캐시 hit rate와 cache write 비용을 함께 측정합니다.
⑤ Async Tool 적용 대상 선정
웹 조회, DB 조회, 외부 API처럼 응답시간이 긴 독립 작업부터 비동기화를 검토합니다.
⑥ Mid-turn Steering 적용
장시간 작업하는 Coding Agent나 Research Agent라면 사용자 개입 UX를 설계합니다.
⑦ Agent 권한 설계
파일 삭제, 배포, 데이터 변경 등 되돌리기 어려운 작업은 애플리케이션 차원의 승인 구조를 유지합니다.
⑧ 실제 Evals 수행
모델만 변경하고 바로 프로덕션에 배포하기보다 정확도, 처리시간, Tool 성공률, 토큰 비용을 기존 모델과 비교해야 합니다.
마무리
GPT-6 Astra에서 가장 중요한 변화는 벤치마크 점수만이 아닙니다.
OpenAI는 이번 세대에서 모델이 도구를 기다리는 방식, 작업 도중 방향을 수정하는 방식, 추론 자원을 조절하는 방식, 그리고 에이전트의 행동을 감시하는 방식까지 API 수준에서 변경했습니다.
이는 AI 시스템이 단순한 질문·답변 인터페이스를 넘어 실제 업무를 수행하는 지속형 에이전트 시스템으로 이동하고 있다는 신호입니다.
앞으로 AI 개발에서 중요한 질문도 달라질 가능성이 높습니다.
과거에는
어떤 프롬프트를 써야 더 좋은 답변이 나올까?
가 중요했다면 앞으로는
어떤 작업을 병렬화할 것인가?
어디까지 자율적으로 실행하게 할 것인가?
언제 사용자가 개입해야 하는가?
작업별 추론 비용을 어떻게 배분할 것인가?
에이전트의 권한과 검증 경계를 어떻게 설계할 것인가?
가 더 중요한 엔지니어링 문제가 될 것입니다.
GPT-6 Astra는 그 변화를 상당히 구체적인 API 형태로 보여주기 시작했습니다.
공식 참고자료
- OpenAI, GPT-6 Astra: A new generation of intelligence, 2026년 9월 3일
- OpenAI Developers, GPT-6 Astra Model Guidance
- OpenAI Developers, GPT-6 Astra Model
- OpenAI, Safety overview: GPT-6 Astra, 2026년 9월 3일
- OpenAI, Path to Astra: Critical capabilities and frontier safeguards, 2026년 9월 1일
'바이브 코딩' 카테고리의 다른 글
| 바이브 코딩으로 앱은 만들었는데 왜 돈은 못 벌까? 앱빌챗이 짚은 AI 앱 개발의 진짜 현실 (0) | 2026.06.19 |
|---|---|
| 맥북 덮어도 AI 에이전트 안 멈춘다? 개발자가 직접 만든 화제의 앱 ‘Electronic Clam’ 정체 (0) | 2026.06.19 |
| Codex Use Cases 완전 정리: AI 코딩 도구를 넘어 “일하는 방식”을 바꾸는 OpenAI Codex 활용법 (0) | 2026.05.27 |
| AI 코딩 에이전트가 코드를 더 빨리 이해하게 만드는 도구, CodeGraph란? (0) | 2026.05.26 |
| AI 하네스(Harness)란 무엇인가? (1) | 2026.04.09 |


