AI가 일을 처리할 때 항상 긴 문장을 만들어야 할까요. 비밀번호를 재설정할지, 담당 부서로 넘길지, 어떤 도구를 실행할지처럼 실제 업무에는 긴 답변보다 ‘여러 선택지 가운데 하나를 빨리 고르는 능력’이 더 중요한 순간이 많습니다.
스탠퍼드대학교와 엔비디아 연구진이 공개한 CLM-8B는 바로 이 부분만 집중적으로 처리하는 AI입니다. 글을 생성하는 대신 현재 상황과 가능한 행동을 비교해 가장 적절한 선택을 골라냅니다.
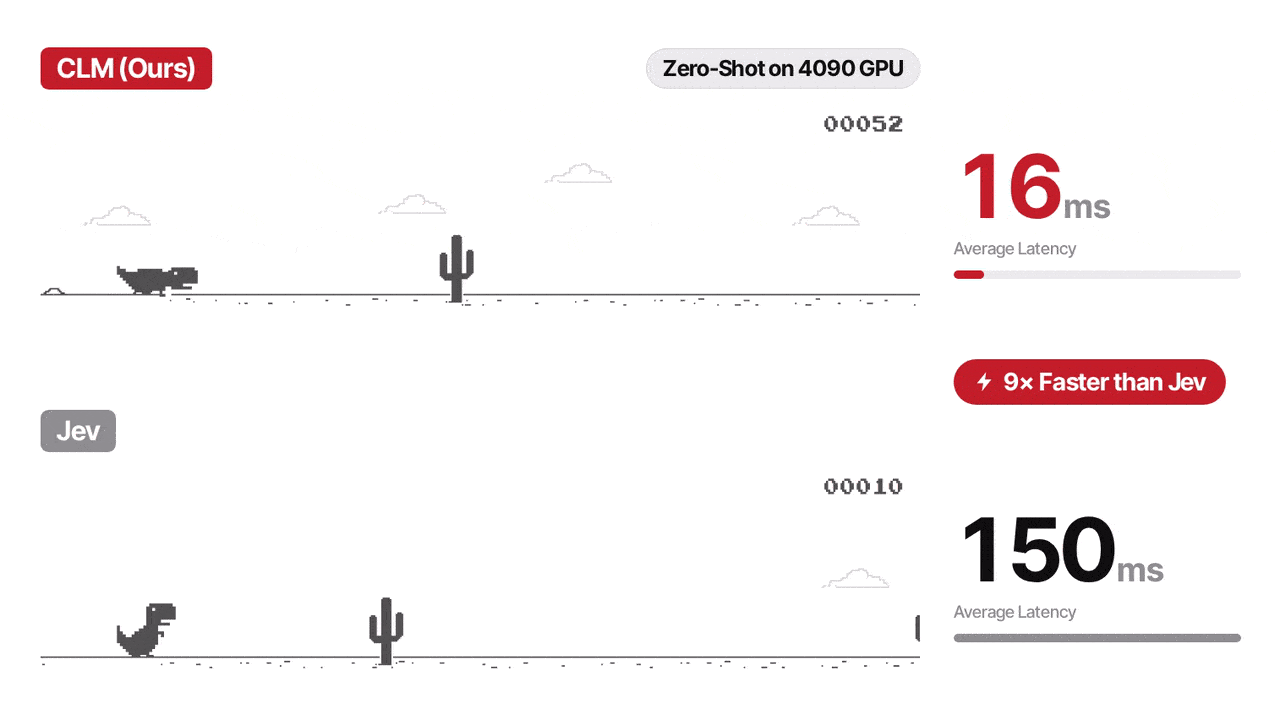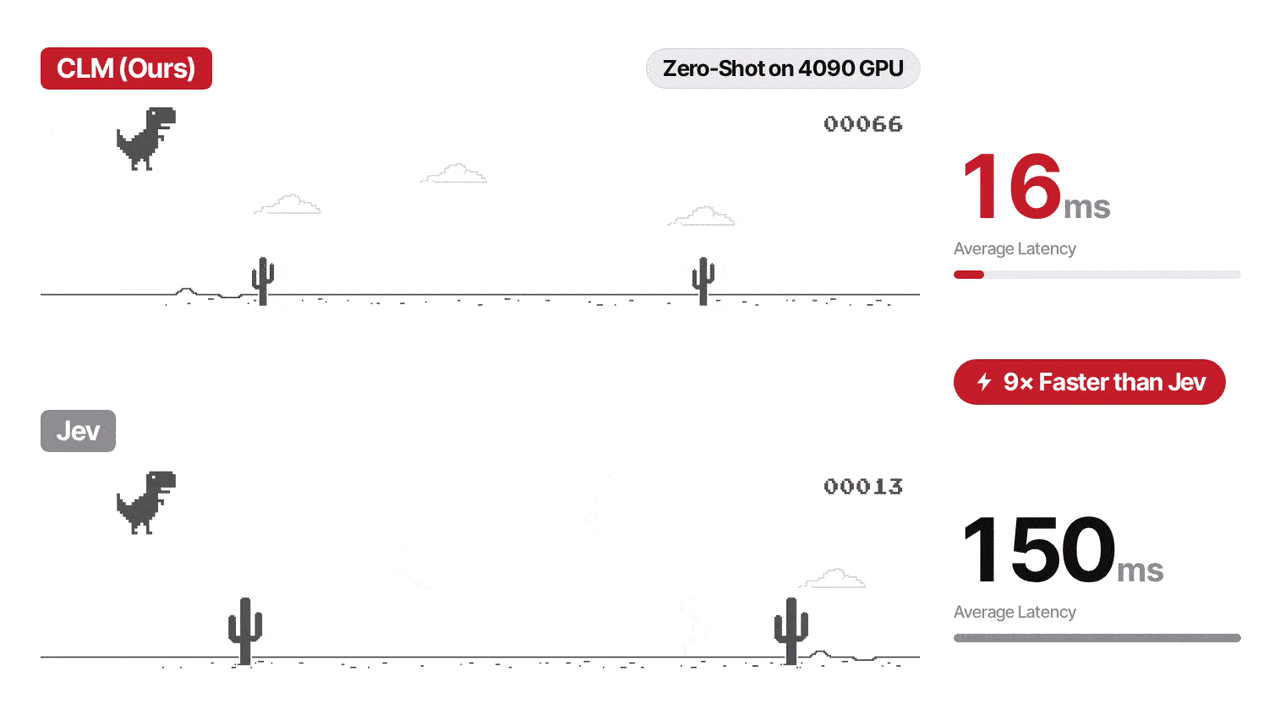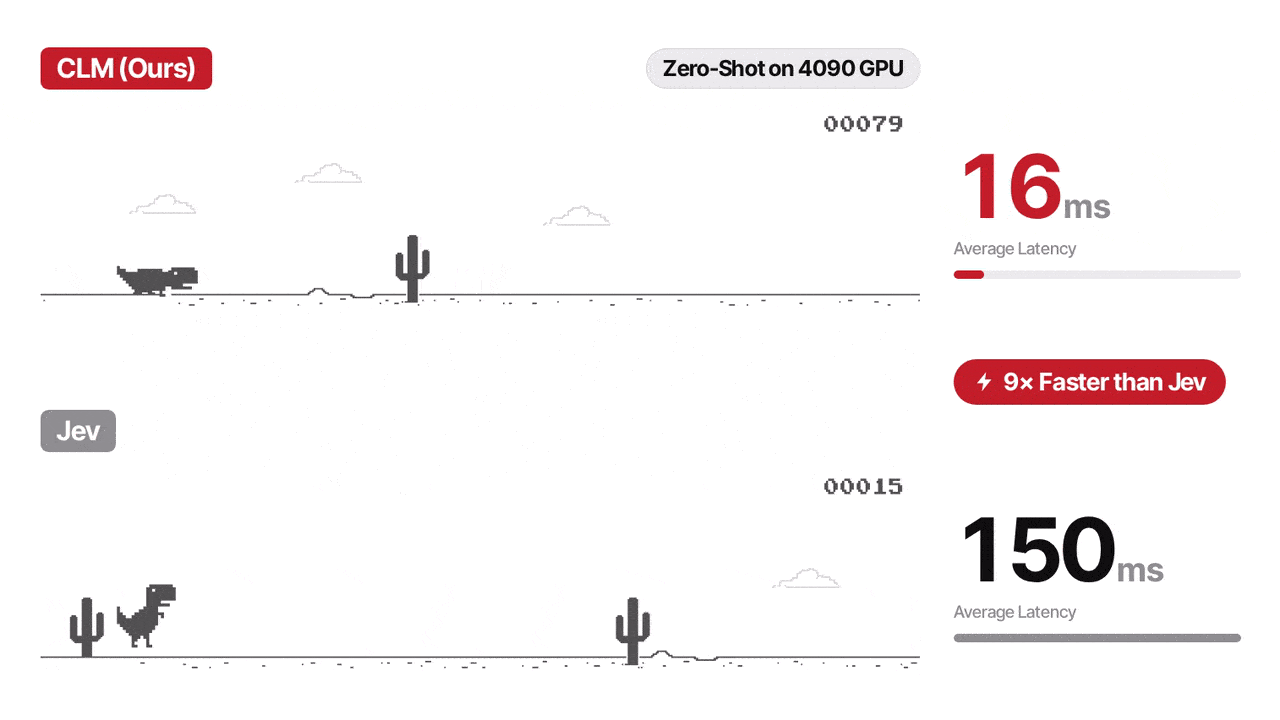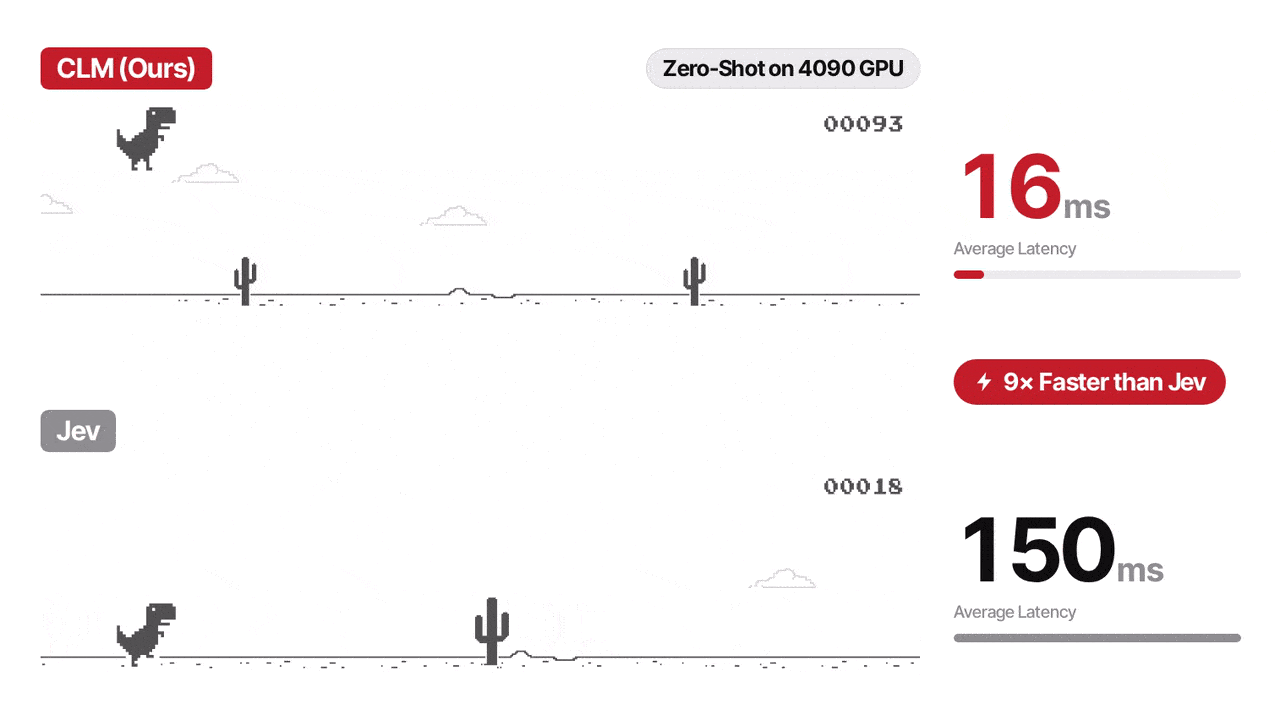
연구진이 공개한 실험에서는 구글 공룡 점프 게임에서 평균 약 16.5ms의 지연시간을 기록해 타입세이프 AI의 Jev 약 149.8ms보다 약 9배 빨랐습니다. 다만 이 숫자는 특정 테스트의 최대 속도 차이입니다. 다른 평가에서는 약 1.6배에서 4배 수준이었고, 정확도에서는 Jev가 더 좋은 결과를 보인 과제도 있습니다.
CLM-8B는 왜 답변을 ‘생성’하지 않을까
ChatGPT와 같은 일반적인 대형언어모델은 다음에 올 토큰을 하나씩 생성하는 방식으로 답변을 만듭니다.
AI 에이전트가 여러 도구 가운데 하나를 선택할 때도 대형언어모델을 사용하면 현재 상황과 도구 설명을 입력한 뒤 모델이 텍스트를 생성하면서 어떤 행동을 할지 결정하게 됩니다.
CLM은 이 과정을 다르게 접근합니다.
현재 상황을 의미를 압축한 숫자 배열인 ‘임베딩’으로 만들고, 가능한 행동 역시 각각 임베딩으로 만듭니다. 이후 현재 상황과 가장 가까운 행동을 찾아 선택합니다.
쉽게 말해 답을 새로 쓰는 대신 준비된 선택지 가운데 가장 잘 맞는 답을 검색하는 방식에 가깝습니다.
연구진은 이를 Contrastive Language Model, 즉 대조 언어모델이라고 부릅니다. CLM은 InfoNCE라는 대조학습 방식을 이용해 올바른 상태와 행동은 서로 가깝게, 잘못된 행동은 멀어지도록 학습합니다.
왜 이렇게 빨라질 수 있을까
핵심은 행동을 매번 다시 계산할 필요가 없다는 데 있습니다.
예를 들어 회사 IT 지원 AI가 다음과 같은 50개의 작업을 할 수 있다고 가정해보겠습니다.
비밀번호 재설정, 계정 잠금 해제, 접근 권한 요청, 보안팀 전달, 상담 티켓 생성 등입니다.
일반적인 생성형 AI 방식에서는 새로운 문의가 들어올 때마다 이러한 도구 정보를 다시 읽고 어떤 행동을 선택할지 추론해야 합니다.
CLM에서는 50개 행동의 임베딩을 미리 계산해 저장해둘 수 있습니다.
새 문의가 들어오면 변화한 현재 상황만 계산한 뒤 이미 저장된 행동들과 비교하면 됩니다.
연구팀이 공개한 GitHub 설명에서도 상태와 행동을 분리해 각각의 임베딩을 독립적으로 캐시하고 재사용하는 것이 CLM의 주요 속도 개선 요인이라고 설명합니다.
‘제브보다 9배 빠르다’ 정확히 따져보면
제목의 9배라는 숫자는 실제 실험 결과에서 나온 수치입니다.
T-Rex 게임에서 CLM-8B의 지연시간은 약 16.5ms, Jev는 약 149.8ms였습니다. 두 모델 모두 5개 테스트에서 모두 성공했습니다.
하지만 다른 테스트 결과를 보면 상황이 조금 달라집니다.
BFCL v4 도구 호출에서는 CLM이 약 76.8ms, Jev가 125.5ms로 약 1.6배 차이였습니다. 정확도는 CLM 95.2%, Jev 99.2%로 Jev가 앞섰습니다.
WikiRacing에서는 CLM이 79.8ms, Jev가 225ms로 CLM이 약 2.8배 빨랐지만, 성공률은 CLM이 30개 중 26개, Jev가 30개 모두를 해결했습니다.
Super Mario에서는 CLM이 약 33.5ms, Jev가 132.6ms로 약 4배 빨랐고 두 모델 모두 테스트를 통과했습니다.
따라서 “CLM이 Jev보다 항상 9배 빠르면서 정확도도 같다”고 이해하면 과장입니다.
정확하게는 특정 반복 행동 선택 과제에서 최대 약 9배 낮은 지연시간을 기록했고, 일부 과제에서는 속도를 얻는 대신 정확도가 다소 낮았습니다.
CLM-8B의 ‘8B’도 조금 다르게 이해해야 한다
CLM-8B는 Qwen3-8B를 기반으로 합니다.
하지만 80억개 매개변수 전체를 CLM 학습 과정에서 다시 훈련한 것은 아닙니다. 연구진은 Qwen3-8B 인코더를 고정한 상태에서 상태와 행동을 처리하기 위한 별도의 프로젝션 헤드를 학습했습니다.
각 인코더는 고정된 LLM 백본과 약 2천만개 매개변수 규모의 학습 가능한 프로젝션 헤드를 사용하는 구조입니다.
이 방식은 기업이 특정 업무에 CLM을 적용할 때도 장점이 될 수 있습니다.
거대한 모델 전체를 다시 학습하기보다 비교적 작은 헤드를 특정 업무 데이터에 맞춰 조정할 수 있기 때문입니다.
6000만 Q&A와 100만개 에이전트 행동으로 학습
CLM-8B는 크게 세 단계로 학습됐습니다.
먼저 약 6000만개의 Nemotron 질의·응답 데이터로 기본적인 의미 관계를 학습했습니다.
그다음 약 3000만개의 ‘하드 네거티브’를 이용했습니다. 하드 네거티브란 얼핏 보면 정답과 비슷하지만 실제로는 틀린 선택지를 의미합니다.
마지막으로 약 100만개의 AI 에이전트 행동 궤적을 학습해 실제 에이전트가 특정 상황에서 어떤 행동을 선택하는지 익혔습니다.
즉 단순한 문장 유사도 모델이 아니라 실제 AI 에이전트의 행동 선택을 위해 별도 학습 과정을 거친 것입니다.
코딩에서는 ‘문제 해결사’가 아니라 ‘심사위원’ 역할
기사에 등장하는 DeepSWE 81.6%, Terminal-Bench 2.1 87.6%라는 숫자는 특히 주의해서 봐야 합니다.
CLM이 코딩 문제를 처음부터 직접 풀어 이 점수를 얻은 것이 아닙니다.
먼저 더 큰 AI 모델이 여러 개의 후보 해법을 생성하고, CLM이 이 가운데 가장 좋은 답을 고르는 검증기, 즉 verifier 역할을 수행했습니다.
연구팀은 DeepSWE에서는 Opus 5가 만든 후보를, Terminal-Bench 2.1에서는 Fable 5가 만든 후보를 CLM과 Jev가 비교·선택하도록 평가했다고 설명합니다.
CLM을 미세조정한 결과 DeepSWE에서 38개 평가 과제 중 31개를 해결해 81.6%, Terminal-Bench 2.1에서는 87.6%를 기록했습니다. 이때 검증 지연시간은 Jev보다 약 4.1~5.7배 낮았습니다.
따라서 CLM을 GPT나 Claude를 대신하는 새로운 코딩 모델로 보는 것은 정확하지 않습니다.
큰 모델이 답을 만들고 CLM이 빠르게 골라주는 분업 구조에 가깝습니다.
일반 챗GPT를 대체하기 어려운 이유
CLM에는 분명한 한계도 있습니다.
“인공지능이 앞으로 사회를 어떻게 바꿀까?”와 같이 정해진 답이 없는 질문에 장문의 글을 작성해야 한다면 CLM의 방식은 적합하지 않습니다.
복잡한 수학 문제를 처음부터 추론하거나, 여러 단계의 새로운 계획을 만들거나, 보고서를 작성하는 일도 마찬가지입니다.
CLM이 강한 영역은 이미 가능한 행동이나 후보가 정해져 있는 경우입니다.
어떤 도구를 실행할지 선택하기, 고객 문의를 어느 부서로 보낼지 결정하기, 여러 후보 코드 중 가장 좋은 결과를 고르기, 검색 결과 순위를 정하기, 에이전트 행동을 모니터링하기 같은 작업입니다.
결국 GPT·Claude 같은 대형 추론 모델과 경쟁하기보다 이들의 반복적인 판단 업무를 대신할 가능성이 더 큽니다.
앞으로 AI 에이전트가 ‘두 개의 뇌’를 쓸 수 있다
CLM이 보여주는 가장 흥미로운 방향은 AI 에이전트가 모든 문제를 하나의 거대한 모델로 해결할 필요가 없다는 점입니다.
어려운 계획을 세우거나 새로운 답을 만들어야 할 때는 GPT, Claude 같은 대형 추론 모델을 사용하고, 이미 정해진 도구 중 하나를 고르거나 결과를 검증하는 반복적인 단계에서는 CLM 같은 빠른 판단 모델을 사용할 수 있습니다.
사람에 비유하면 복잡한 문제를 천천히 생각하는 뇌와 익숙한 상황에 즉각 반응하는 뇌를 나누는 방식입니다.
연구팀 역시 CLM을 ‘System One Model’이라고 표현합니다. 빠르고 반복적인 판단을 담당하고, 느리지만 깊은 추론이 필요한 문제는 대형 모델에 맡기는 구조입니다.
오픈소스라는 점도 제브와 다른 부분
CLM의 또 다른 특징은 기술이 공개돼 있다는 점입니다.
연구진은 CLM 코드뿐 아니라 CLM-8B 모델 가중치도 Apache 2.0 라이선스로 공개했습니다. 실제 GitHub 저장소의 라이선스 역시 Apache License 2.0으로 확인됩니다.
공식 저장소에서는 pip 패키지 설치 방법과 로컬 서버 실행법, 자체 데이터 미세조정 방법, 플레이그라운드까지 제공하고 있습니다.
Qwen3-8B 기반 인코더와 약 75MB 규모의 기본 CLM 헤드를 이용해 직접 서버를 구성하는 방법도 공개돼 있습니다.
폐쇄형 서비스인 Jev와 달리 개발자가 직접 모델을 내려받아 테스트하고 수정할 수 있다는 점에서 앞으로 독립적인 성능 검증도 더 활발해질 가능성이 있습니다.
다만 현재 벤치마크는 ‘연구팀 자체 결과’다
여기서 반드시 짚고 넘어갈 부분이 있습니다.
현재 널리 인용되는 CLM과 Jev의 성능 비교는 CLM 연구진이 공개한 벤치마크 결과입니다.
특히 9배 속도 차이가 나온 T-Rex 테스트처럼 후보 행동을 반복적으로 재사용할 수 있는 구조는 CLM의 캐싱 방식에 매우 유리합니다.
반대로 BFCL과 WikiRacing에서는 Jev가 정확도에서 앞섰습니다.
따라서 CLM이 판단형 AI 시장에서 Jev를 완전히 넘어섰다고 결론 내리기에는 아직 이릅니다. 별도의 연구기관이나 개발자가 같은 하드웨어와 동일한 조건에서 수행하는 독립적인 재현 결과가 더 필요합니다.
다음 모델은 멀티모달까지 간다
CLM 팀은 현재 공개 모델에서 끝내지 않을 계획입니다.
공식 GitHub 로드맵에는 더 큰 백본을 활용한 확장 실험뿐 아니라 이미지와 영상 등 멀티모달 지원을 추가해 로봇과 컴퓨터 사용 작업으로 영역을 넓히겠다는 계획이 들어 있습니다.
기사에서 언급된 CLM-35B-A3B의 구체적인 공개 일정은 향후 실제 릴리스 여부를 추가로 확인할 필요가 있습니다.
현재 확실하게 공개돼 직접 사용할 수 있는 모델은 CLM-8B입니다.
AI 경쟁의 다음 단계는 ‘더 똑똑한 모델’만이 아니다
CLM-8B가 흥미로운 이유는 GPT보다 더 똑똑한 모델이 등장했기 때문이 아닙니다.
오히려 반대입니다.
굳이 거대한 모델이 깊게 생각할 필요가 없는 간단한 판단을 더 빠르고 싸게 처리하는 별도의 AI를 만드는 접근입니다.
앞으로 AI 에이전트가 수십 번, 수백 번 도구를 선택하고 결과를 검증하게 되면 매 단계마다 최고급 모델을 호출하는 비용과 지연시간이 문제가 될 수 있습니다.
이때 CLM 같은 판단 전용 모델이 일상적인 결정을 담당하고, 정말 어려운 순간에만 대형 추론 모델을 부르는 구조가 자리 잡는다면 AI 에이전트의 속도와 비용 구조 자체가 달라질 수 있습니다.
따라서 “제브보다 9배 빠르다”는 숫자 하나보다 더 중요한 변화는 AI 모델의 역할이 ‘생성하는 모델’과 ‘판단하는 모델’로 세분화되기 시작했다는 점입니다.
확인한 자료
Contrastive-LM 공식 GitHub 저장소에서 CLM-8B의 Qwen3-8B 기반 구조, 6000만 Q&A·3000만 하드 네거티브·100만 에이전트 궤적 학습, DeepSWE 81.6%, Terminal-Bench 2.1 87.6% 결과를 확인했습니다.
공식 GitHub와 Hugging Face에서 CLM 코드와 모델 가중치가 Apache 2.0 라이선스로 공개된 것도 확인됩니다.
9배 속도 차이는 T-Rex 평가에서 나온 최대치이며 BFCL v4와 WikiRacing에서는 Jev의 성공률이 더 높았습니다.
당신을 위한 3줄 요약
CLM-8B는 문장을 생성하지 않고 현재 상황과 후보 행동을 비교해 AI 에이전트의 다음 행동을 빠르게 선택하는 판단 전용 모델입니다.
‘제브보다 9배 빠르다’는 T-Rex 테스트에서 나온 최대 수치이며, BFCL과 WikiRacing에서는 Jev가 정확도에서 더 높은 결과를 기록했습니다.
CLM은 GPT나 Claude를 대체하기보다 대형 모델이 만든 결과를 선택·검증하거나 반복적인 도구 호출을 처리하는 보조 AI로 활용될 가능성이 큽니다.
3 line summary for you
CLM-8B is a decision-focused model that selects among candidate actions instead of generating long-form text.
Its “9× faster than Jev” result comes from a specific T-Rex benchmark, while Jev remains more accurate on some other tasks.
CLM is more likely to complement large reasoning models as a fast action selector and verifier than replace them.
멀리 있어도, 마음은 곁에.
부모님의 작은 변화를 놓치지 않도록.
AI 동반자와 가족을 연결하는 KINORA
부모님에게는 따뜻한 친구를, 가족에게는 안심을.
🎁 지금 출시 알림을 신청하세요.
출시 알림을 신청하신 분께 KINORA 정식 출시 후 1개월 무료 이용권을 드립니다.
👉 KINORA 출시 알림 신청하기
https://www.kinora.date
KINORA — 멀리 있어도, 마음은 곁에.
AI 반려친구가 부모님의 일상을 함께하며 가족에게 꼭 필요한 순간을 알려줍니다. KINORA와 함께 출시 알림을 받아보세요.
www.kinora.date
KINORA ✦ Stay close, even from afar.
© 2026 KINORA. All rights reserved.
📘 외국어 학습, Loglingo로 시작하세요
Loglingo는 외국어 학습에 특화된 AI 일기 플랫폼입니다.
모국어와 학습어를 선택하면, 학습어로 작성한 일기의 문법과 표현을 정확히 교정해줍니다.
🌍 전 세계 라디오로 듣기 연습
🗣 말하기 연습 모드 제공
📊 AI가 학습 레벨을 자동 분석해 맞춤 피드백 제공일기를 쓰는 순간, 실력이 쌓입니다.
https://www.loglingo.com
Loglingo
AI-powered language learning diary
www.loglingo.com
모두의 박물관
새로운 지식과 흥미로운 디지털 콘텐츠를 한곳에서 만나보세요.
배우고, 체험하고, 생각을 확장하는 온라인 공간.
블록체인 박물관
금융 박물관
대한민국 실패 박물관
다이어트 박물관
재난 박물관
AI 박물관
성수 박물관 ( 2026년 9월1일 개관 )
친일 박물관
🌐 https://maccrey.com
모두의 박물관 | 무료 체험형 디지털 박물관
블록체인, 금융지식, 실패, 성수, 몸과 체중, 재난 안전을 무료로 체험하는 다국어 디지털 박물관 모음입니다.
maccrey.com
암호화폐 하드월렛 한국 판매량 1위 디센트
디센트 X + 리커버리 카드 키트 - 구독자 전용 한정 혜택
꺼내서, 대고, 끝. 2.4인치 AMOLED 화면으로 서명 내용을 또렷이 확인하고, 0.5초 지문 인증으로 바로 승인합니다. 100+ 네트워크 1만개 이상의 토큰 지원. 리커버리 카드 호환.
store-kr.dcentwallet.com
디센트S+리커버리 카드 키트 - 구독자 전용 한정 혜택
디센트 S — R3covery 백업 카드형 암호화폐 콜드월렛 카드형 암호화폐 하드웨어 지갑 디센트 S. R3covery 듀얼 카드 백업으로 카드를 잃어도 코인은 그대로. 100+ 네트워크·EAL6+ 보안칩. 사라진 채 두
store-kr.dcentwallet.com
'Development News > AI' 카테고리의 다른 글
| 메타 ‘뮤즈 포 스몰 비즈니스’ 공개…쇼피파이·퀵북스까지 연결하는 AI 직원, 어디까지 대신하나 (0) | 2026.10.01 |
|---|---|
| 클링 4.0 공개, 최대 30초·15개 참조 입력…시댄스 추격할 핵심 변화는 (0) | 2026.09.30 |
| 일레븐랩스 Eleven v4 공개, TTS 아레나 1위…10초 음성 복제·150ms 응답 무엇이 달라졌나 (0) | 2026.09.30 |
| OpenAI DevDay 2026 총정리 (0) | 2026.09.30 |
| 오픈AI ‘닷츠’ 공개, 24시간 일하는 AI 등장…기업용만일까? 공식 발표 확인해보니 (0) | 2026.09.30 |


